Что такое дата-центры, что в них хранится и почему их восстановление может занять месяцы
Автор: Редакция LeaksMedia

Отключение одного дата-центра может затронуть тысячи сайтов, банковские приложения, онлайн-магазины и привычные цифровые сервисы. Пользователи перестают получать доступ к файлам, оплачивать покупки или вызывать такси, хотя интернет на их устройствах продолжает работать. Причина в том, что значительная часть цифровой инфраструктуры зависит от огромных комплексов с серверами, которые называют дата-центрами, или центрами обработки данных (ЦОД).
В октябре 2026 года вопрос об их работе стал особенно актуальным. С 8 по 11 октября были повреждены три дата-центра «Яндекса» — в Сасове, Калуге и Владимире. Согласно официальному сообщению компании, после атак беспилотников работа площадок в Сасове и Владимире полностью остановилась, а в Калуге часть инфраструктуры вышла из строя. Компания предупредила, что оценка повреждений продолжается и точные сроки восстановления назвать сложно. О последствиях происшествий также сообщало агентство Reuters.
Чтобы понять, почему восстановление может занимать недели и даже месяцы, необходимо разобраться, как устроены дата-центры, какую информацию они обрабатывают и почему нельзя просто заменить повреждённый компьютер другим.
Что такое дата-центр и какая информация там хранится
Дата-центр — это специально оборудованное здание или комплекс помещений, в котором размещаются серверы, системы хранения данных и сетевое оборудование. По определению Amazon Web Services, такая инфраструктура обеспечивает работу цифровых сервисов, корпоративных приложений и систем обработки информации.
Если обычный компьютер выполняет задачи одного пользователя, серверы в дата-центре могут одновременно обслуживать огромное количество людей. Например, когда человек открывает онлайн-магазин, запрос поступает на сервер, который обрабатывает его и возвращает необходимую информацию. При оформлении покупки другие системы проверяют наличие товара, создают заказ и взаимодействуют с платёжными сервисами. Принцип такой работы подробно объясняет Cloudflare.
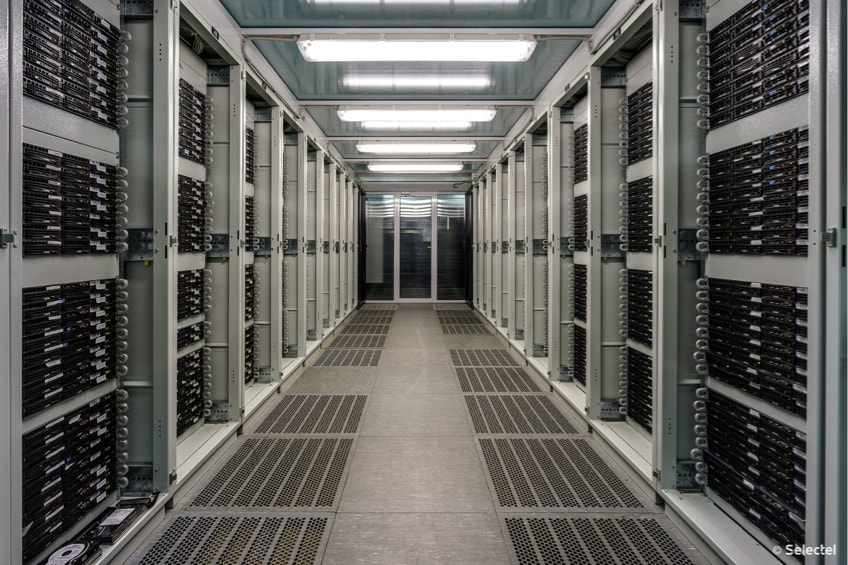
В дата-центрах могут храниться фотографии и видео пользователей, электронные письма, документы, резервные копии, базы данных компаний, история заказов, настройки приложений и другая цифровая информация. Там же работают системы, которые обрабатывают эти данные. Как отмечает IBM, современные ЦОД используются не только для хранения файлов, но и для запуска программ, обработки запросов и предоставления вычислительных ресурсов.
Однако представлять дата-центр как гигантский жёсткий диск неправильно. Внутри находятся многочисленные серверные стойки, в которых размещаются вычислительные устройства и накопители. Одни серверы хранят информацию, другие выполняют расчёты, третьи отвечают за работу приложений или взаимодействие между отдельными системами. В частности, мощные вычислительные комплексы используются для обучения и работы искусственного интеллекта.
Кроме серверов, дата-центру необходимы системы электропитания, охлаждения, связи, мониторинга и физической безопасности. Оборудование выделяет большое количество тепла и требует постоянного отвода энергии. Для защиты от отключений электричества используются источники бесперебойного питания и резервные генераторы. Подробнее устройство таких комплексов описано в техническом руководстве AWS.
Масштабы этой инфраструктуры постоянно увеличиваются. По данным Международного энергетического агентства, в 2024 году дата-центры потребили около 415 тераватт-часов электроэнергии — примерно 1,5% мирового потребления. Развитие искусственного интеллекта и облачных технологий усиливает потребность в новых вычислительных мощностях.
При этом данные одного пользователя или компании не обязательно находятся в одном конкретном здании. Современные системы могут распределять информацию между несколькими серверами и дата-центрами, иногда расположенными в разных регионах. Такая архитектура помогает защищать сервисы от отдельных технических неисправностей и физических повреждений.
В зависимости от масштаба аварии последствия могут быть совершенно разными. Если отключается один сервер, его задачи иногда автоматически перенаправляются на другие машины. Но когда одновременно перестают работать целые группы серверов, системы хранения, сети или несколько площадок, последствия оказываются гораздо серьёзнее.
Именно поэтому крупные дата-центры давно стали важной частью современной инфраструктуры. От них зависят не только развлечения и социальные сети, но и торговля, логистика, финансовые операции, корпоративные системы и некоторые государственные услуги.
Почему дата-центры так долго восстанавливаются и не спасают ли резервные копии
На первый взгляд кажется, что проблему можно решить простым перезапуском оборудования. Однако дата-центр представляет собой сложную систему, в которой серверы зависят от электричества, охлаждения, сетевых соединений и множества программных компонентов. Восстановление одного элемента не означает, что всё остальное немедленно заработает.
После серьёзной аварии специалисты прежде всего оценивают безопасность здания и состояние оборудования. Если произошёл пожар, затопление или физическое повреждение инфраструктуры, необходимо проверить электропроводку, системы питания, охлаждения и серверные стойки. В некоторых случаях оборудование нельзя включать до завершения диагностики, поскольку это создаёт риск новых повреждений.
Реальный пример произошёл 10 марта 2021 года во французском Страсбурге, где пожар уничтожил один из дата-центров OVHcloud и повредил соседний. В официальной хронике восстановления OVHcloud описано, как специалисты поэтапно проверяли оборудование, очищали серверы, восстанавливали электроснабжение и переносили инфраструктуру на другие площадки. Даже 23 апреля, спустя более шести недель после пожара, компания продолжала работы по восстановлению и предоставлению замещающих ресурсов части клиентов.
Другая проблема заключается в том, что заменить сервер физически недостаточно. На новом оборудовании необходимо восстановить программное обеспечение, конфигурации, базы данных, сетевые настройки и связи с другими системами. Причём эти компоненты должны работать согласованно. Если, например, сервер приложения восстановлен, но база данных или служба авторизации недоступна, пользователь всё равно не сможет воспользоваться сервисом.
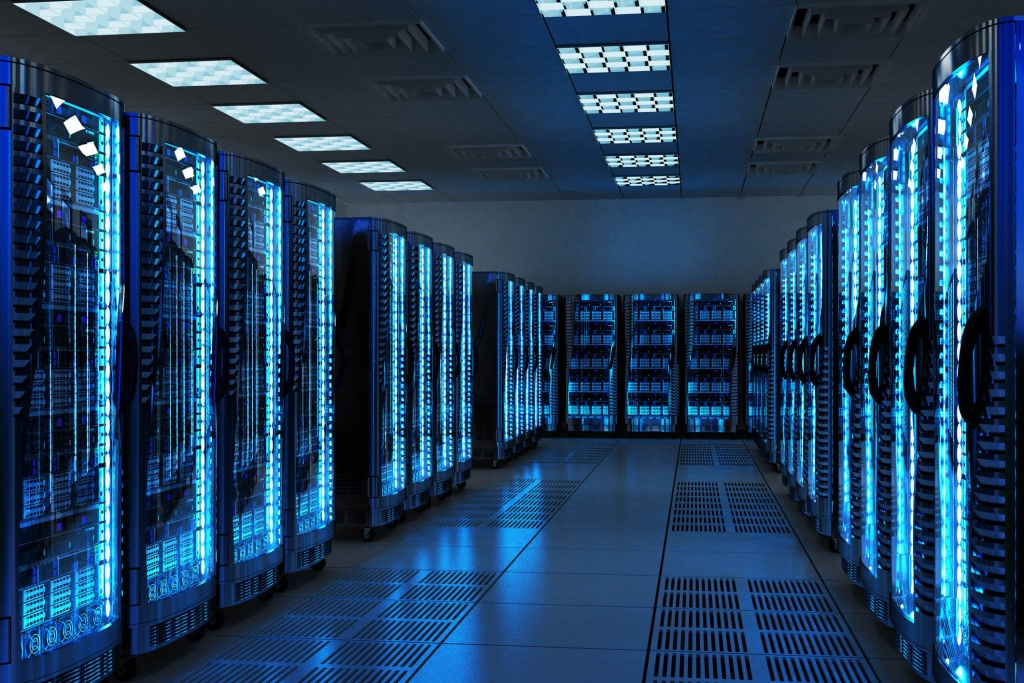
Существуют также ограничения на скорость передачи и восстановления больших объёмов информации. Даже если резервные копии сохранились, перенос данных и подготовка новой инфраструктуры могут занимать значительное время. После восстановления инженеры должны проверить целостность информации, согласованность баз данных и корректность обработки операций. Особенно важны такие проверки для финансовых и других критически значимых систем.
Отдельно следует различать резервное копирование и репликацию. Резервная копия позволяет восстановить данные из сохранённого состояния, а репликация предполагает создание и обновление дополнительных копий информации на других системах. Репликация помогает сохранить доступность данных при некоторых авариях, но не всегда защищает от случайного удаления или повреждения информации: нежелательные изменения тоже могут распространиться на копии. На это обращает внимание AWS в руководстве по аварийному восстановлению.
Поэтому сохранность информации ещё не означает, что приложение способно немедленно продолжить работу. Хороший пример — ситуация с «Яндекс Пэй». В сообщении от 11 октября 2026 года руководитель финтех-направления «Яндекса» Дима Пирогов объяснил, что сведения о счетах хранятся в нескольких копиях на разных площадках. Компания проверила их целостность и не обнаружила потерянных записей. Тем не менее пользователи столкнулись с ограничениями при проверке баланса, оплате покупок и переводах, а точные сроки восстановления на момент заявления оставались неизвестны.
Для защиты от подобных ситуаций крупные компании используют несколько дата-центров. Например, Microsoft описывает архитектуру зон доступности Azure, каждая из которых имеет независимую инфраструктуру электропитания, охлаждения и сетевого подключения. При правильной настройке приложения могут продолжать работать за счёт ресурсов других зон. Но наличие таких зон само по себе ещё не гарантирует отказоустойчивость каждого сервиса: многое зависит от того, как он спроектирован и где размещены его компоненты.
Существуют и разные стратегии восстановления после катастроф. Согласно документации AWS, организация может ограничиться резервными копиями, поддерживать уменьшенную резервную инфраструктуру или использовать несколько одновременно работающих площадок. Последний подход способен значительно сократить простой, но требует дополнительных затрат и сложной синхронизации систем.
В этой области применяются два важных показателя: RTO — целевое время восстановления сервиса, и RPO — максимально допустимый период потенциальной потери данных. Как объясняет Google Cloud, эти параметры используются для планирования работы после серьёзных сбоев. Однако они отражают требования и возможности конкретной системы, а не универсальную гарантию, что любая авария будет устранена за определённое количество часов.

Поэтому время восстановления всегда зависит от характера происшествия. Программную ошибку иногда удаётся устранить достаточно быстро, а при масштабном физическом разрушении приходится заменять оборудование и переносить целые информационные системы. Более того, первоначальный дата-центр может оставаться неработоспособным, даже когда часть обслуживавшихся им сервисов уже успешно перенесена на другие площадки.
Именно так объясняется ситуация, когда один сервис возвращается к работе через несколько часов, а другой остаётся недоступным гораздо дольше. Например, 13 октября «Яндекс» сообщил, что после повреждений дата-центров удалось восстановить доступ к партнёрскому кабинету РСЯ, Adfox и ряду других инструментов. При этом некоторые функции продолжали работать с ограничениями, несмотря на сохранность статистики и рекламных данных.
Главное, что нужно понимать: дата-центр — это не просто помещение с компьютерами, а основа работы множества цифровых систем. Его повреждение не обязательно означает потерю файлов, денег или личных данных. Но для возвращения привычных сервисов недостаточно сохранить информацию — необходимо восстановить целую технологическую инфраструктуру, проверить её безопасность и убедиться, что все компоненты снова работают вместе. В зависимости от масштаба аварии этот процесс действительно может занять недели или месяцы.
Читайте также на LeaksMedia: Массовый сбой «Яндекса» затронул такси, доставку и другие сервисы: что произошло и когда всё заработает.